全面介绍
AI 驱动的真人口播视频生成方案
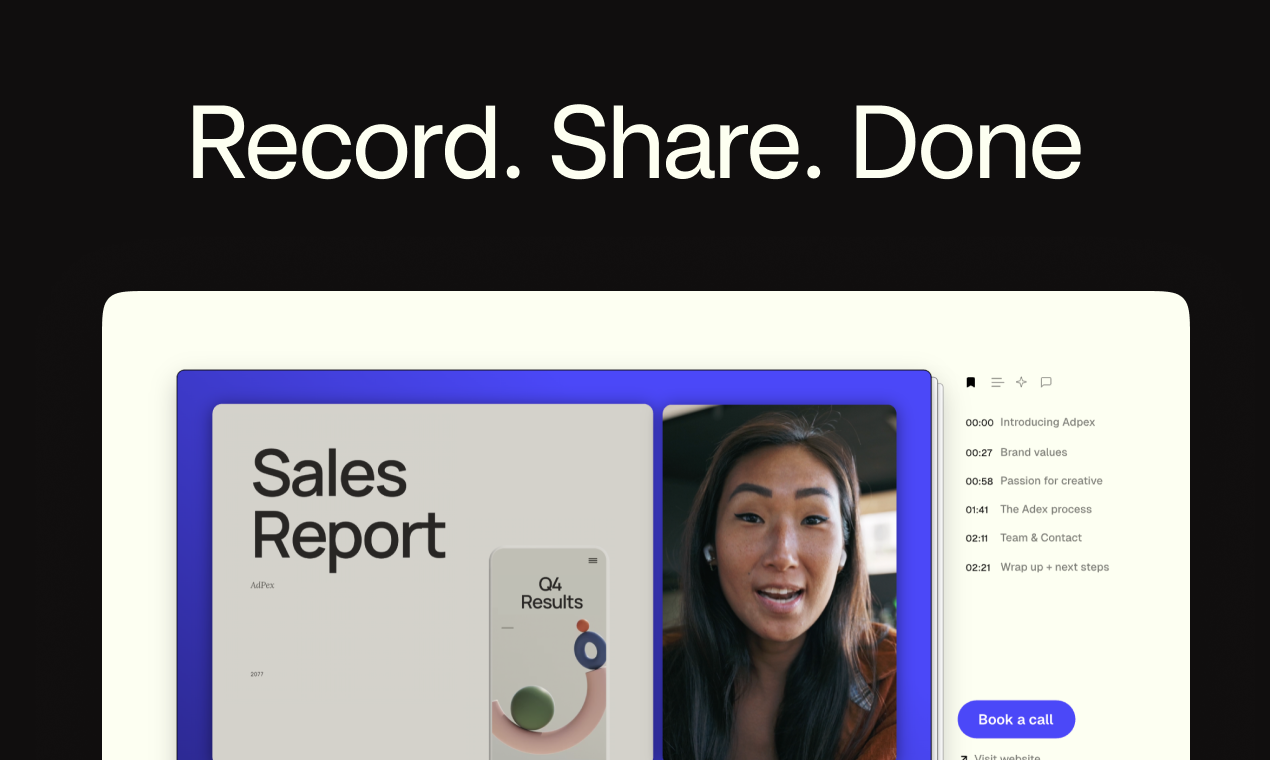
通过融合前沿人工智能技术,将静态照片与文本或音频转化为自然流畅的真人播报视频。无需专业背景,即可快速产出高质量的多语言视频内容。
🎯 核心技术架构
平台依托两大核心引擎构建:
- Stable Diffusion:确保视觉生成质量与人物神态自然度
- GPT-3:驱动语言理解与口型同步的精准匹配
💡 极简创作流程
只需三步即可完成视频制作:
- 上传一张人物照片作为虚拟主播形象
- 输入文本或上传音频作为播报内容
- 选择目标语言,自动生成同步口播视频
实时人像功能支持从单张照片生成动态视频,虚拟主播可基于文本或音频驱动,实现逼真的面部表情与口型同步。
🌐 全球化语言支持
打破语言壁垒,支持超过 100 种语言的视频输出。无论是主流国际语言还是区域特色语种,均可保持一致的生成质量与口播自然度。
✨ 逼真效果保障
API 模型基于数万个真实视频样本进行深度训练,确保生成结果在口型匹配、微表情呈现及整体观感上达到高度拟真,显著降低传统视频制作的技术门槛与成本投入。
产品评分
暂无评分
登录后即可评分