点击查看大图
点击查看大图
点击查看大图
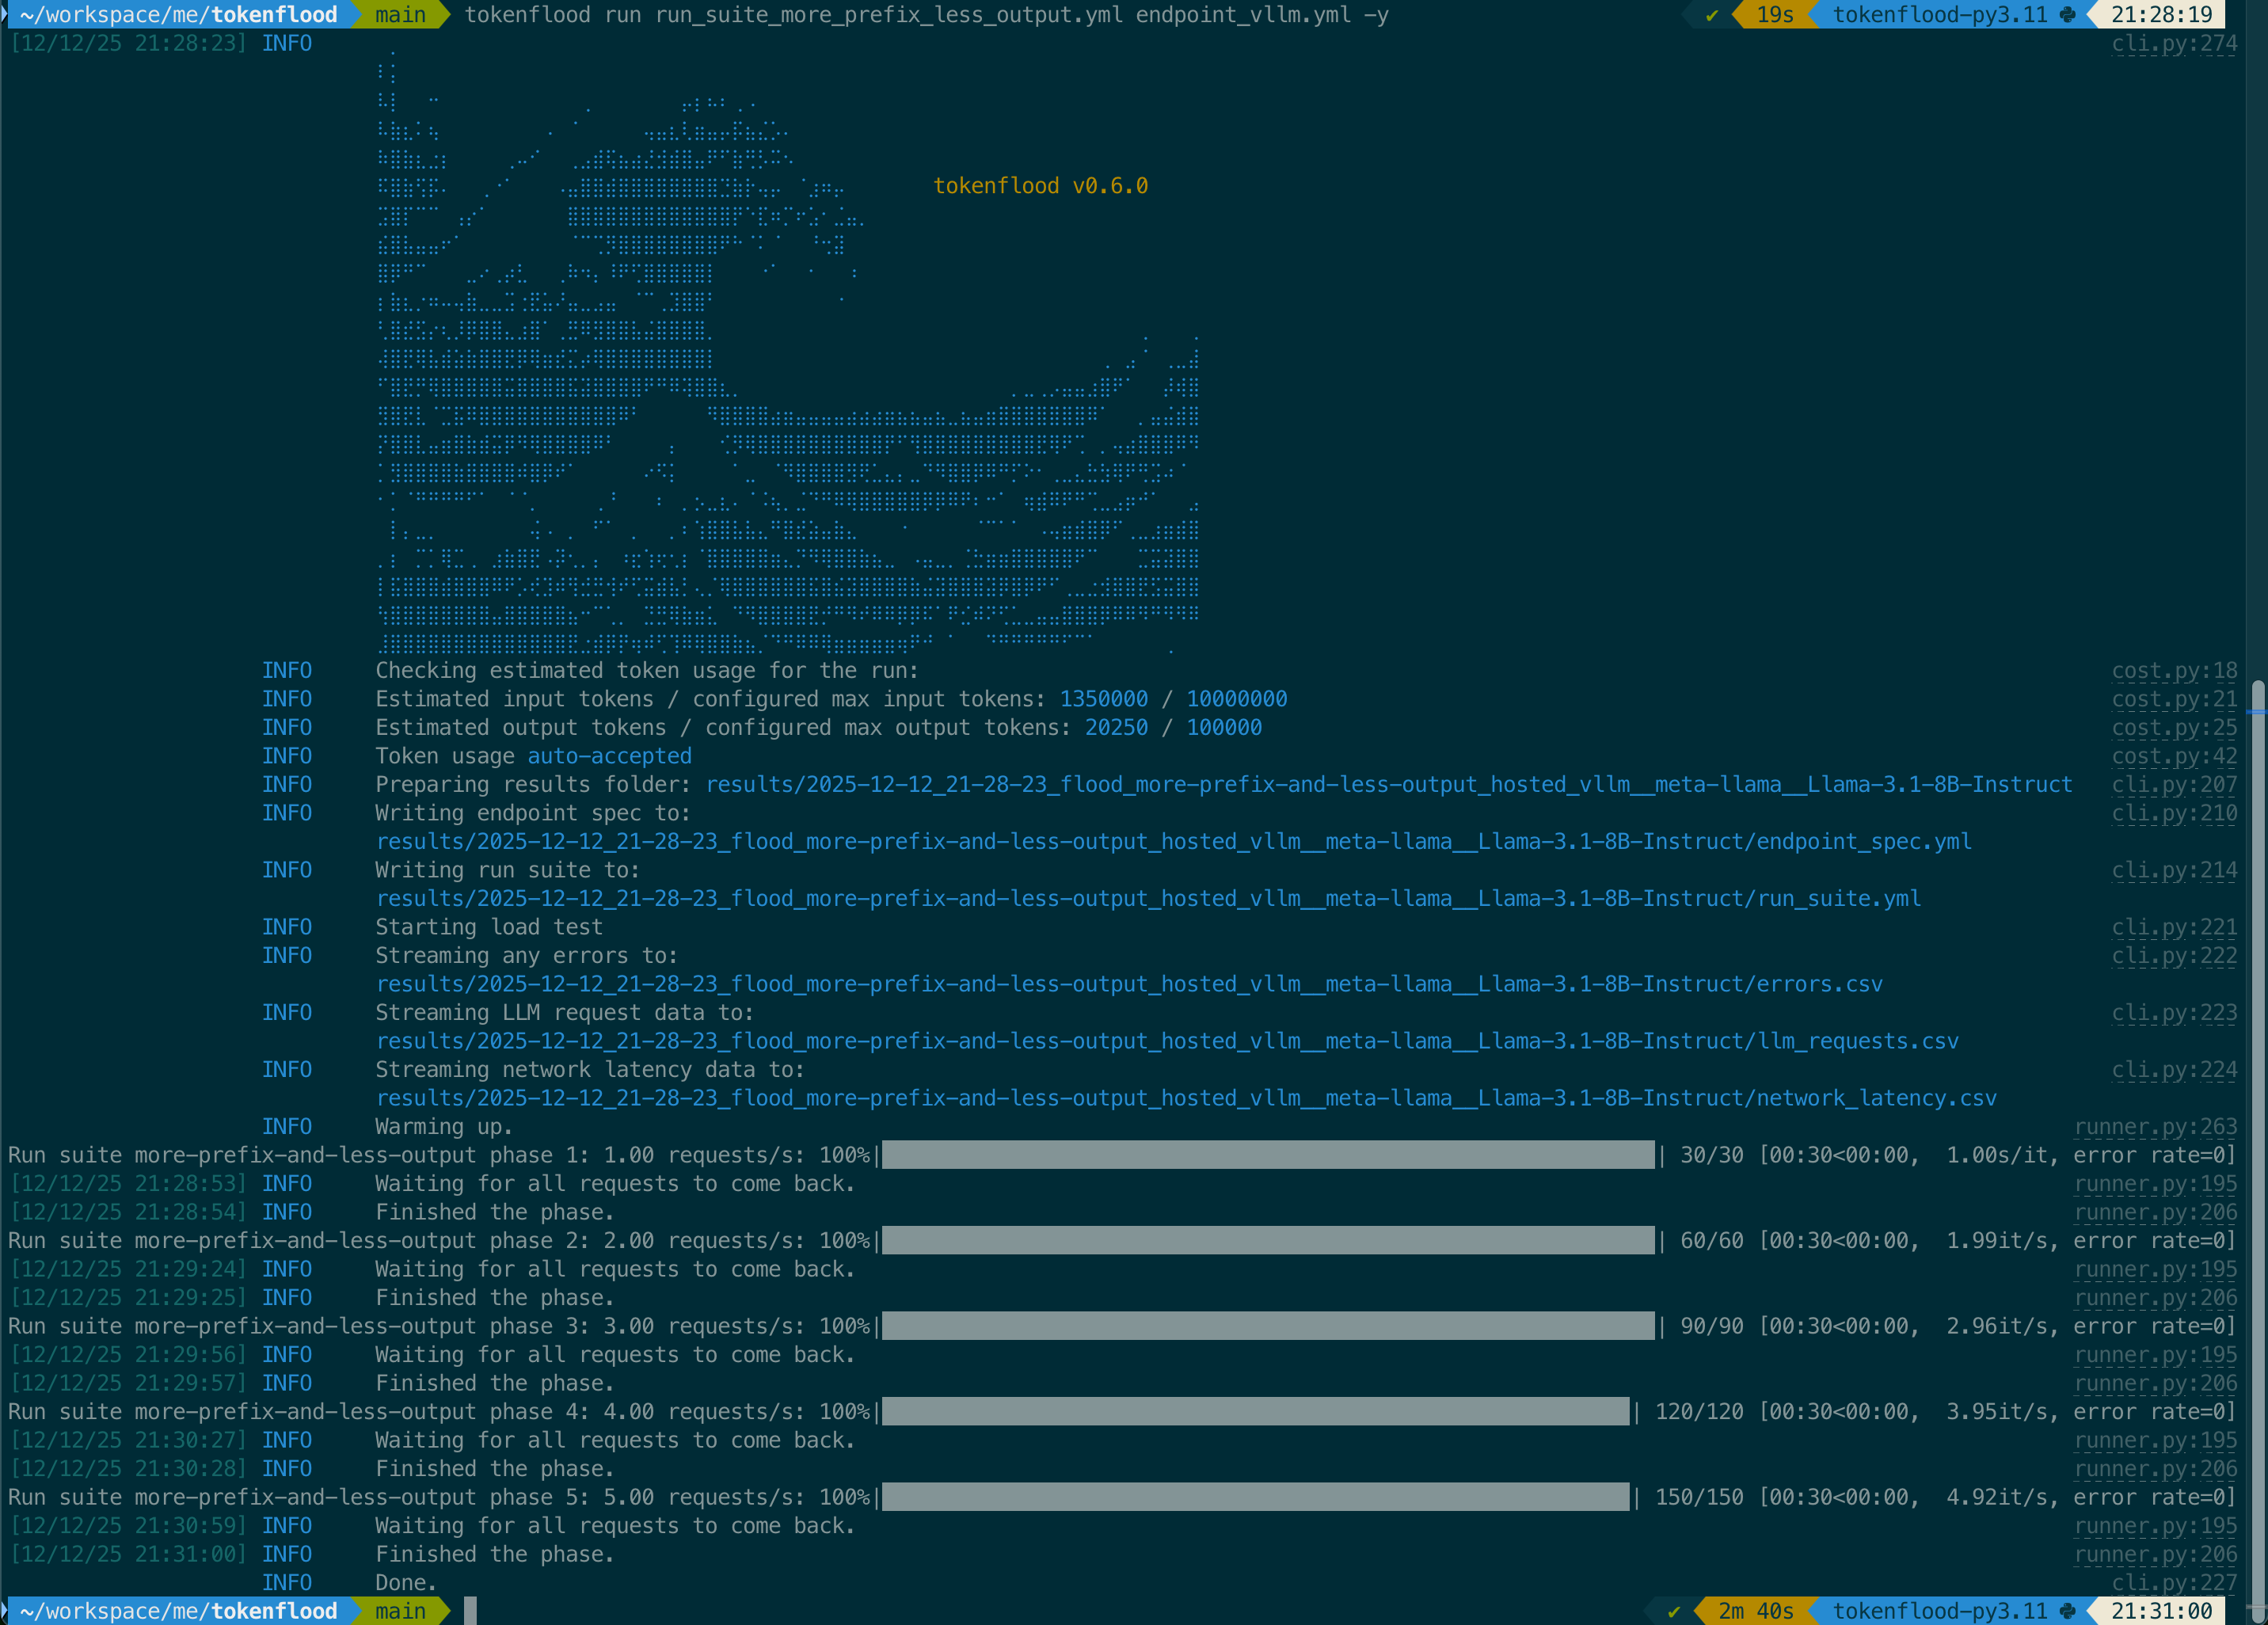
点击查看大图
全面介绍
✨ **Tokenflood**: 优化您的 LLM 性能,告别等待!✨
还在为大型语言模型(LLM)响应缓慢而烦恼吗?Tokenflood 是您的理想解决方案!我们帮助您精准定位并解决性能瓶颈,助您的应用更快、更稳定、更经济地运行。
🎯 Tokenflood 如何助您一臂之力?
-
💡 精准洞察与优化提示词
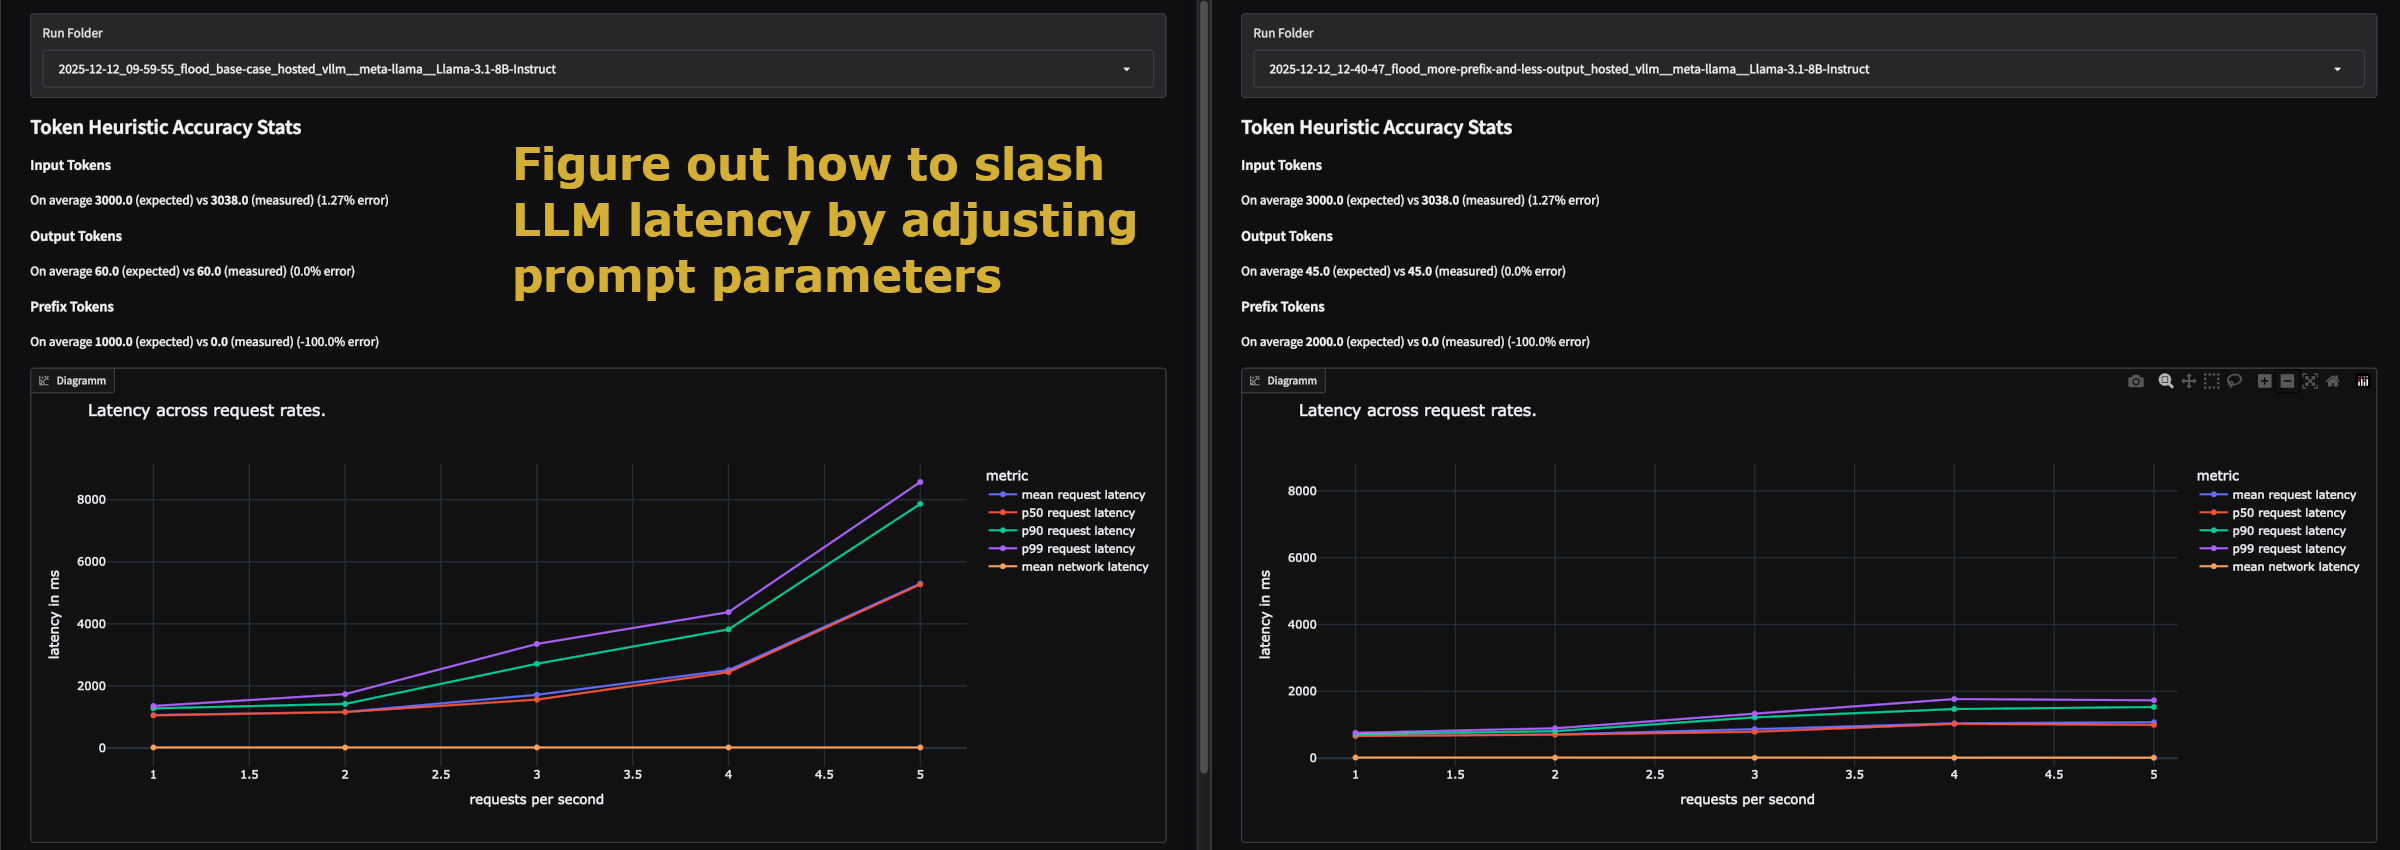
Tokenflood 会深入分析您的提示词和参数设置,找出其中导致模型响应变慢的“元凶”。我们帮助您进行智能调整,大幅削减不必要的等待时间,让您的LLM应用流畅如飞。
“通过调整提示词与参数,找出并大幅削减导致模型响应变慢的环节。”
-
📈 预估高并发下的表现
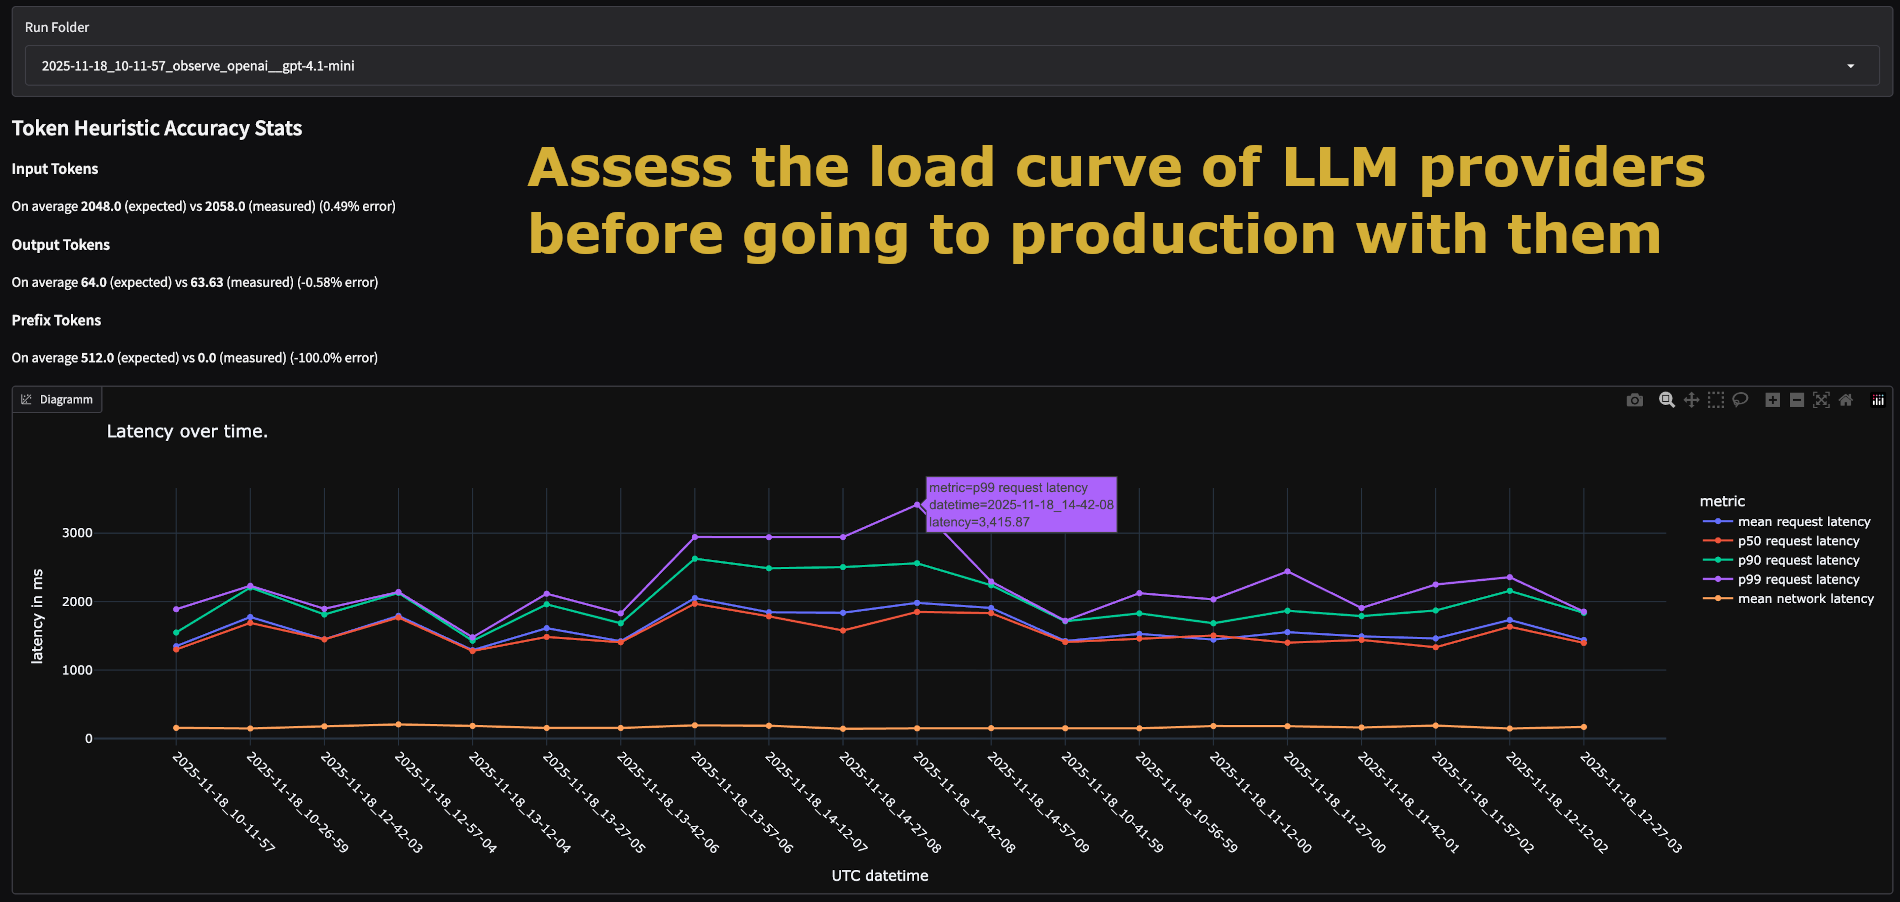
在您的应用上线前,Tokenflood 可以评估不同LLM服务商在高并发负载下的响应曲线。这意味着您可以提前预见并解决潜在的性能问题,避免生产环境中的“意外惊喜”,确保用户体验始终如一。
“在上线前评估各家 LLM 服务商的负载响应曲线,让你提前看到高并发下的表现,避免生产环境的性能惊喜。”
🚀 为什么选择 Tokenflood?
- 直观易用的分析: 即使是非技术背景的团队成员也能轻松理解性能报告。
- 更快上线: 显著缩短优化周期,加速产品迭代上线。
- 更稳运行: 提前规避风险,确保在高负载下依然表现出色。
- 更省成本: 优化资源使用,降低LLM的运行成本。
Tokenflood 致力于让开发者和产品团队更快、更稳、更省心地优化延迟与成本。让我们一起打造卓越的LLM应用体验!
产品评分
暂无评分
登录后即可评分