点击查看大图
全面介绍
✨ TTS,让文字开口说话|Qwen3‑TTS 大众版落地页 🚀
Qwen3‑TTS 将文字瞬间变成自然语音,为您的内容注入生命!感受科技与温度的完美融合。
💡 产品亮点一览
- 自然好声音:内置 49+ 种高品质音色,为您提供丰富选择,让文字摆脱冰冷,充满情感。
- 多语种支持:无论是中文方言(如粤语、四川话、上海话)还是多国语言,都能轻松驾驭,实现无缝切换。
- 近乎实时:语音生成速度快如闪电(约 97ms),流畅体验不间断。
- 开源与本地部署:支持开源,方便您在本地部署,数据隐私尽在掌控。
- 超值免费额度:每月赠送 50 万字符的免费额度,让您轻松体验高品质语音服务。
📚 TTS 应用场景,不止于此
Qwen3-TTS 适用范围广泛,只需粘贴文字,即可快速生成优质语音:
- 📖 有声阅读/文章朗读:告别阅读疲劳,享受舒适的听书体验。
- 🎬 短视频/广告配音:融入地方方言,表达丰富情感,批量制作更高效。
- 👨🏫 课程/演示文稿朗读:清晰稳定,让您的内容传达更具感染力。
- 🧭 导航/提醒:自然友好的语音提示,告别生硬机械。
- 🤖 AI 伴侣/助手:像真人一样交流,提供实时响应。
- 🤝 辅助功能:为视障人士提供更友好的信息获取方式。
“告别文字的冰冷,用声音温暖世界。”
🎧 聆听差异,感受真实(TTS 试听)
我们提供在线 Demo,您可以选择不同的音色和方言,调整语速、音量和音高,即刻体验并下载 MP3/WAV 格式的音频。
🌍 支持多样的方言与音色:
- 中文方言:粤语、四川话、吴语(上海)、闽南语、北京话、天津话、南京话、陕西话等。
- 多种国际语言。
您可以自定义语速、音量、音高和比特率,同时系统会尊重标点符号,确保生成自然停顿的语音。
🚀 快速上手,三步轻松实现
- 复制文字:选择您想要朗读的文本内容。
- 选择音色/方言:例如,选择“中文女声”或“粤语男声”。
- 播放与下载:满意后即可保存为 MP3 或 WAV 格式。
📱 移动端使用小贴士:
- 微信:长按选中文字 → 朗读。
- iPhone:辅助功能 → 朗读内容。
- Android:文本转语音设置。
👩💻 开发者集成,灵活高效
Qwen3-TTS 提供强大且易于集成的 API 接口,助您的应用快速接入语音能力。
⚡ 实时 API:
https://dashscope.aliyuncs.com/compatible-mode/v1/services/aigc/multimodal-conversation
- 每月 50 万字符免费额度。
- 请将长文本分段(建议每段小于 500 字符),并合理使用标点符号控制停顿。
- 指定语言和方言参数以优化效果。
🌐 WebSocket 连接:
wss://dashscope-intl.aliyuncs.com/api-ws/v1/realtime?model=qwen3-tts-flash-realtime
⚙️ 音频参数配置:
format='wav'sample_rate=22050bitrate='128k'presence_penalty=0.6(可用于减少重复性)
示例代码(Python):
import dashscope
dashscope.api_key = 'your_api_key'
response = dashscope.Audio.speech_synthesizer(
    model='qwen3-tts-flash-realtime',
    text='你好,这是 Qwen3-TTS 测试。',
    voice='中文女声',
    language='zh'
)
print(response.output_audio)
❓ 常见问题解答
- API Key 无效或区域不匹配?
💡 北京区使用
sk-,国际区使用sk-intl-。请在 dashscope.aliyuncs.com 选择对应区域生成与重置 Key。 - 延迟较高或断开连接?
💡 建议使用 WebSocket 并添加重连机制;本地部署可选用
flash-realtime版本。 - 发音不自然或有重复?
💡 长文本请分段(每段小于 500 字符);活用标点符号控制节奏;选择匹配内容语气的音色;可尝试调整
presence_penalty参数。 - 支持自定义音色克隆吗?
💡 官方暂不内置。您可利用开源工具如 So-VITS-SVC / XTTS 训练模型后,路由 Qwen3 输出实现音色克隆。
- 本地部署加载慢或内存不足?
💡 确保已安装
pip install transformers torch;使用from transformers import QwenTTSForConditionalGeneration;GPU 需 CUDA 11+;CPU 模式请添加--device cpu;内存不足可尝试 FP8 量化。 - 免费额度和计费?
💡 每月约 50 万字符免费额度(约 400 分钟);批量调用可分批进行。亦可选择开源本地部署,实现完全免费。
- 多语种/方言出现问题?
💡 请明确指定
language与dialect参数;建议先用短句测试。英文与中文无缝切换效果更佳。俄语等语种建议稍慢速。 - 格式不受支持或质量差?
💡 请正确设置
format、sample_rate和bitrate参数。在保存前检查文本是否有乱码。 - 工具集成错误?
💡 更新
dashscope和qwen-tts库。必要时可添加torch.no_grad()防止内存泄漏。 - Demo 加载慢或无声音?
💡 尝试刷新页面或使用隐身模式浏览器。必要时可在本地克隆 Hugging Face Space。同时检查设备权限是否允许播放音频。
🎯 TTS 对比与选择
✨ 核心优势:
- 自然度:各语种 WER 表现出色,中文和多语种合成稳定。
- 方言与语种:支持 9 种中文方言和 10 种其他语言,实现无缝语码切换。
- 开放性与成本:支持本地开源部署;云端每月提供 50 万字符免费额度,低成本高性能。
🛠️ TTS 技术概览
⚙️ 核心架构:
Transformer + MoE (Mixture of Experts) 架构,构建统一的多模态框架。
📦 语音合成流程:
分词/编码 → MoE 韵律预测 → VQ-VAE → 梅尔谱图生成 → HiFi-GAN 声码器(输出 22kHz 音频)。
🔑 技术亮点:
- 自适应韵律:确保语音自然流畅。
- RLHF 稳定性:通过强化学习与人类反馈对齐,提升合成质量。
- CUDA Graph:实现低延迟高性能。
💰 定价与合规
💳 定价与额度:
每月约 50 万字符免费额度(约 400 分钟)。提供低成本模型供选择。本地开源版本完全免费。
🔒 合规与安全:
采用 Apache 2.0 许可证。支持本地运行,有效保护您的数据隐私。请确保用于音色克隆的数据已获得授权。
产品评分
暂无评分
登录后即可评分
相关产品

ElevenLabs UI
开源语音 AI 组件,快速搭建语音体验
0
472
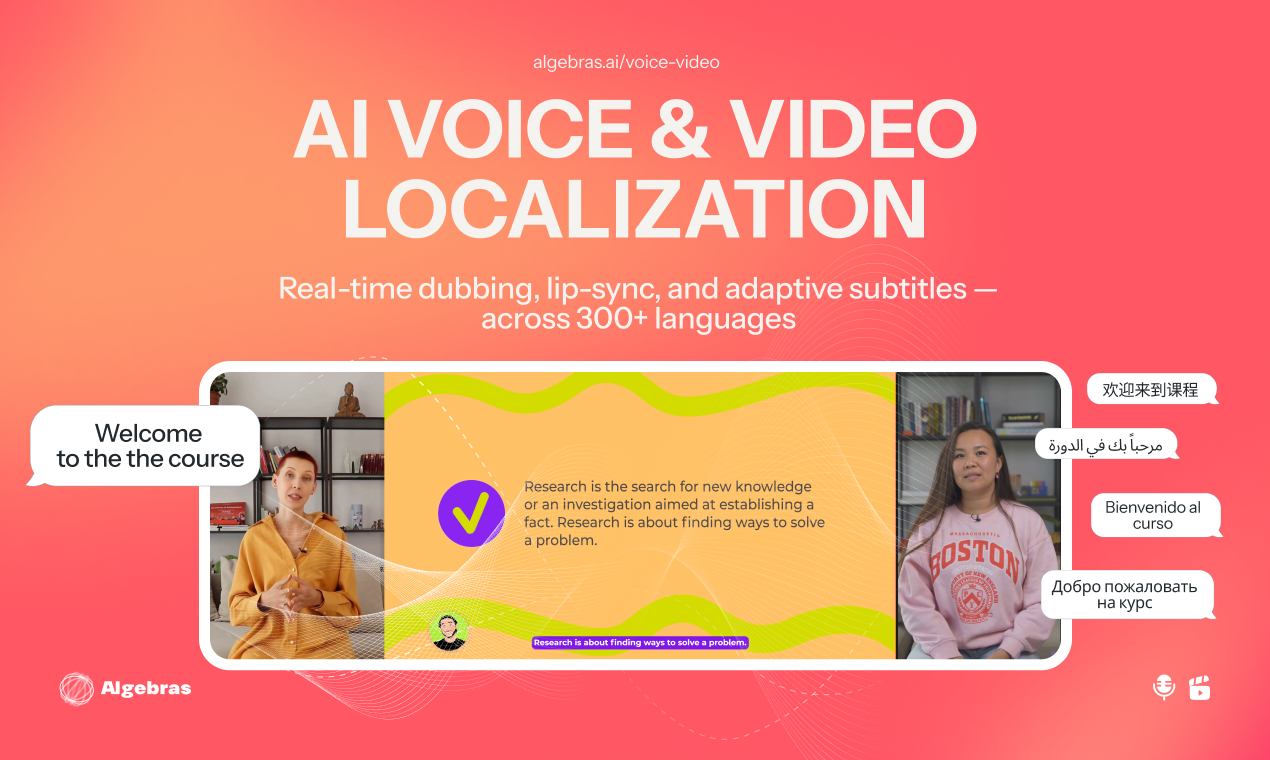
Video Localization by Algebras
让配音更具人情味,精准适配32种语言
4
465
ACE Studio 2.0
一站式 AI 音乐创作画布
1
448
maestro SFX by beatoven.ai
您专属的AI音效师,打造完美声效

0
408
Vaani
为创作者、品牌和工作室打造的精准语音同步AI配音工具
0
325
Music Videos by Mozart
从对话到成曲、短MV,一键发布
1
201
Lyria Camera by Google DeepMind
把相机变成你的随身乐器
0
170
Pianolyze
在浏览器中使用AI学习任何钢琴曲!
0
157